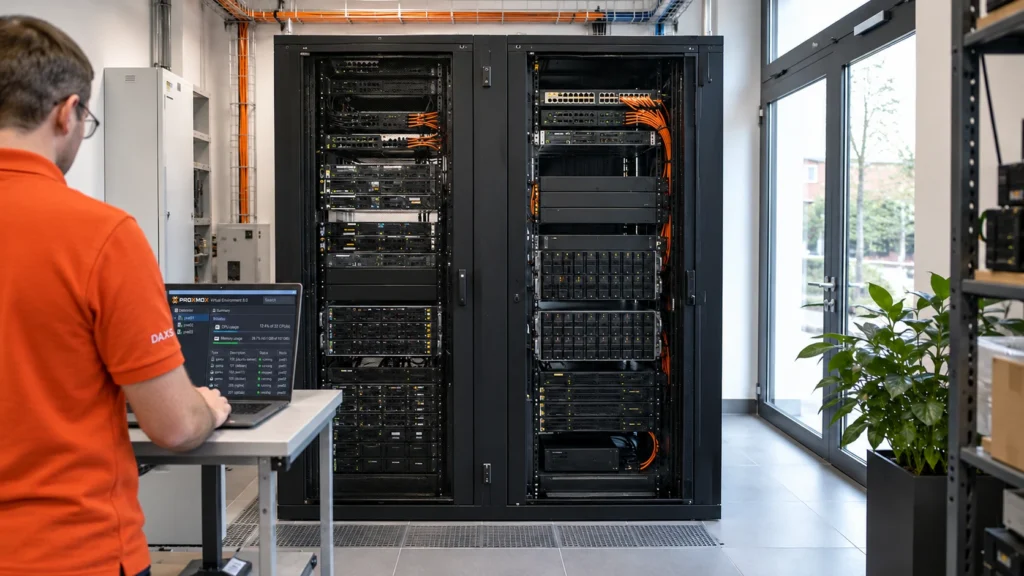
Sull’host Proxmox esistente c’è ancora spazio per un servizio IA. Basta installare una scheda grafica e creare una macchina virtuale? Può essere una soluzione sensata se assegnazione GPU, risorse dell’host e manutenzione vengono pianificate insieme.
Con il passthrough, la GPU fisica appartiene a una VM
Il passthrough PCIe assegna a una macchina virtuale il controllo di un dispositivo fisico. La VM IA usa la GPU tramite il proprio driver guest. Durante questa assegnazione, l’host e le altre VM non possono utilizzare contemporaneamente la stessa scheda per i propri calcoli.
All’interno della VM IA, un servizio di modelli condiviso può gestire più richieste. È diverso dal suddividere la scheda fra più VM. L’idoneità di una soluzione vGPU separata dipende anche da GPU, hypervisor, driver, configurazioni supportate e licenze.
Il vantaggio della VM è un ambiente di sistema chiaramente assegnato: sistema operativo, server di modelli e dati necessari possono essere gestiti insieme. La GPU resta un dispositivo fisico con requisiti propri.
Verificare l’intera catena hardware prima dell’installazione
La documentazione Proxmox richiede il supporto IOMMU, incluso l’interrupt remapping. CPU, scheda madre, firmware e supporto Linux devono essere compatibili. La sola indicazione VT-d o AMD-Vi non sostituisce questa verifica.
Conta anche il gruppo IOMMU dello slot scelto. La GPU e le sue funzioni associate devono essere adeguatamente separate dagli altri dispositivi necessari. La documentazione Linux VFIO spiega perché il gruppo costituisce il confine di assegnazione e isolamento. Uno slot diverso può produrre un raggruppamento diverso.
Si verificano inoltre spazio, collegamento elettrico PCIe, alimentazione e raffreddamento. Nel guest servono un driver GPU adeguato e il supporto del servizio di modelli. Per il passthrough GPU, Proxmox consiglia generalmente q35 con OVMF/UEFI e PCIe; anche il firmware della scheda deve essere adatto. Le impostazioni concrete dipendono dall’hardware utilizzato.

La capacità disponibile è un budget condiviso
L’esempio di pianificazione considera un host di virtualizzazione esistente con applicazioni aziendali e una VM IA aggiuntiva. Tempo CPU, memoria, storage e rete restano risorse condivise. Un’importazione incontrollata di documenti o l’avvio di un modello non devono rallentare inaspettatamente le altre applicazioni.
Alla VM vengono quindi assegnate una configurazione comprensibile e soglie di carico. Memoria grafica, lunghezza del contesto e richieste simultanee al modello si testano insieme. Aumentare la RAM della VM non aumenta la VRAM fisica della scheda. L’offloading sulla CPU può cambiare il comportamento e richiede misurazioni specifiche.
Per un confronto equo si registrano versione del modello, input, contesto e parallelismo. Si valutano qualità, prima risposta, output successivo, attesa e impatto sulle altre VM. Una percentuale generica di overhead della virtualizzazione sarebbe poco utile senza questa prova concreta.
VM o macchina dedicata: cosa cambia nella gestione?
| Domanda | VM IA con passthrough GPU | Server IA dedicato |
|---|---|---|
| Risorse | GPU assegnata stabilmente; coordinare le altre risorse dell’host con le VM esistenti. | Risorse di calcolo e memoria disponibili al sistema dedicato. |
| Manutenzione | Pianificare insieme driver guest, gestione dei modelli e aggiornamenti Proxmox/host. | Sistema operativo e gestione dei modelli in un ambito di manutenzione separato. |
| Cambio di host | I dispositivi PCI assegnati direttamente impediscono la normale migrazione live. Per una migrazione a VM arrestata, verificare hardware di destinazione e assegnazione adeguati. | Trasferimento o sostituzione tramite un ripristino preparato su altro hardware. |
| Backup | Considerare insieme dischi VM, coerenza applicativa, configurazione e assegnazione dei dispositivi. | Organizzare separatamente dati di sistema/applicativi e ripristino. |
| Impegno | Si può usare l’infrastruttura esistente; conteggiare integrazione e dipendenze aggiuntive dall’host. | Prevedere hardware dedicato e risorse del sito, con manutenzione più nettamente separata. |
Un cluster esistente non rende automaticamente trasferibile senza interruzioni una VM IA legata a hardware reale. Per riavviarla su un altro nodo servono risorse GPU compatibili, un’assegnazione valida e una procedura realmente testata. I requisiti di servizio determinano se questa preparazione basta o se è opportuno un ulteriore nodo di servizio.
Un ripristino deve dimostrare più del semplice avvio della VM
Una copia del disco virtuale non contiene lo stato in esecuzione della scheda grafica fisica. Durante il ripristino si verificano quindi anche versioni dei modelli, configurazione, permessi sui dati e nuova assegnazione del dispositivo. Uno snapshot sullo stesso host non sostituisce un backup separato.
Il collaudo comprende un normale riavvio della VM, il riavvio dell’host, un cambio di driver/kernel nella finestra di manutenzione prevista e un ripristino pianificato. Poi si verificano una vera richiesta al modello e le altre applicazioni. Diventa così evidente se il dispositivo torna correttamente disponibile dopo il riavvio.
Un acceleratore usato solo per il calcolo non richiede un monitor collegato alla GPU. La console Proxmox non mostra automaticamente l’immagine di una GPU in passthrough. Il servizio IA si usa tramite la sua interfaccia o API prevista.
Confermare la scelta con un pilot limitato
DAXS chiarisce prima attività, host esistente, utilizzo e interruzione accettabile. Un pilot limitato verifica poi assegnazione dei dispositivi, qualità funzionale e impatto operativo. In base ai risultati possono essere adatti una VM, una macchina dedicata o un servizio esterno.
La panoramica Proxmox per le aziende spiega la scelta generale della piattaforma. La pagina sull’infrastruttura LLM locale e il pilot di test del carico approfondiscono il dimensionamento. Per il servizio condiviso, il contributo su Ollama e Open WebUI completa l’architettura.
Discutere modello operativo IA e infrastruttura esistente.
Fonti: Proxmox: passthrough PCIe (link esterno) · Proxmox: migrazione delle macchine virtuali (link esterno) · Linux: VFIO e gruppi IOMMU (link esterno) · NVIDIA: matrice di supporto vGPU (link esterno) · Ollama: supporto hardware (link esterno).