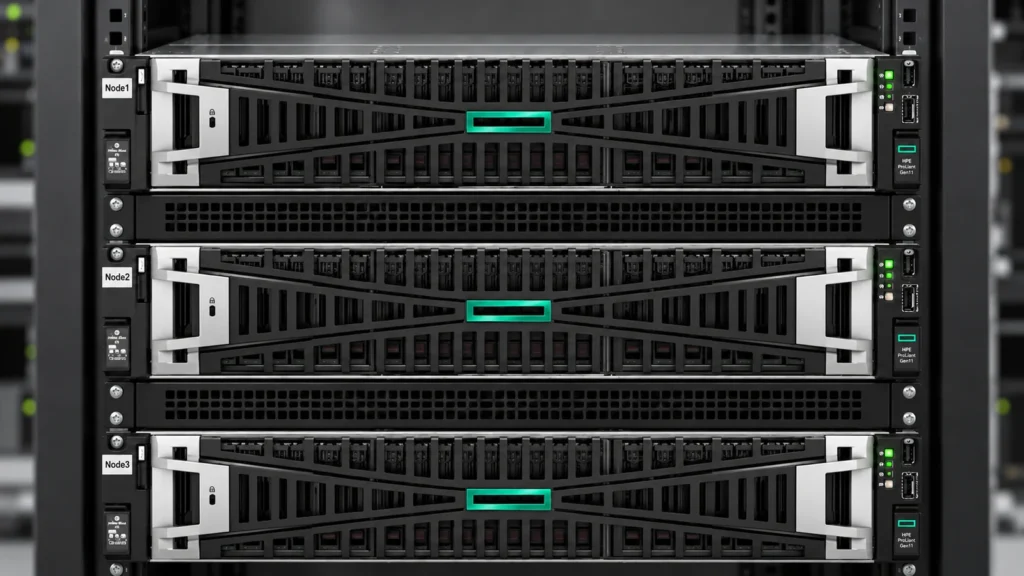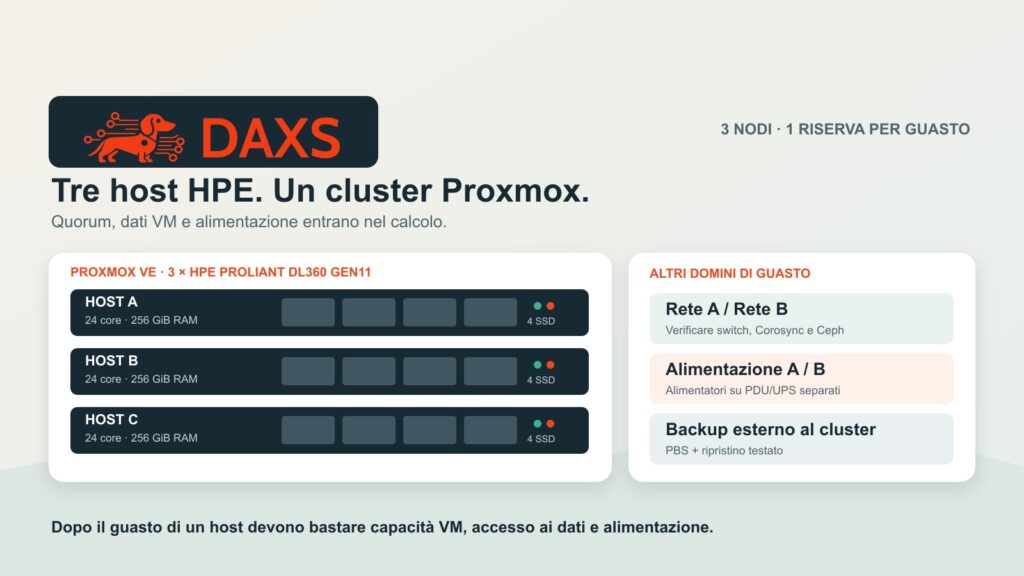
Tre server rack HPE da soli non costituiscono un cluster Proxmox resiliente. L’obiettivo si può verificare solo se dopo il guasto di un nodo rimangono sufficienti capacità di calcolo, memoria, dati VM raggiungibili, rete e percorsi di alimentazione. Questo esempio mostra le decisioni necessarie per un cluster Proxmox VE con tre HPE ProLiant DL360 Gen11.
L’articolo descrive un profilo di dimensionamento ipotetico, non un codice d’ordine HPE già definito. Per nodo si ipotizzano una CPU a 24 core, 256 GiB di RAM ECC, supporti di avvio in mirroring, quattro SSD SAS enterprise da 3,84 TB ciascuno per i dati VM, due alimentatori ridondanti e connessioni di rete adeguate a 25 Gbit. HPE propone il DL360 Gen11 come server rack con opzioni CPU, DIMM, unità, rete e alimentatori. La compatibilità di questa precisa combinazione di CPU, backplane, modalità HBA/JBOD, tipo di SSD, ventole, NIC, cavi e firmware richiede una distinta e una verifica di compatibilità confermate dal partner HPE. I dischi OSD Ceph non devono essere nascosti da un array RAID hardware inadeguato.
La riserva basta dopo il guasto di un host?
Tre nodi offrono 72 core CPU fisici e 768 GiB di RAM lorda. Se uno si guasta rimangono 48 core e 512 GiB. Nell’esempio si riservano su ciascun host restante quattro core e 32 GiB per Proxmox, Ceph e picchi operativi. Per le VM rimangono quindi, secondo il calcolo, 40 core equivalenti e 448 GiB di RAM. Un picco misurato di 28 core equivalenti e 300 GiB di RAM VM lascerebbe in questo modello un margine di 12 core equivalenti e 148 GiB. Il solo numero di vCPU non è una misura: CPU steal, NUMA, I/O, occupazione RAM e distribuzione delle singole VM grandi vanno rilevati nel pilota. Il collaudo comprende anche il tempo di riavvio e le priorità delle applicazioni.
Per un quorum affidabile in alta disponibilità Proxmox richiede almeno tre voti. Con tre nodi di pari peso, dopo il guasto di uno restano due voti e quindi la maggioranza. Questo non garantisce ancora il riavvio delle VM: dati raggiungibili, risorse sull’host di destinazione e regole HA appropriate rimangono necessari. La rete Corosync richiede latenza bassa e stabile e un secondo percorso indipendente. Uno switch comune guasto o una PDU condivisa annullano la ridondanza degli host prevista.
SSD locali: quali dati restano disponibili dopo un guasto?
In questo esempio i dodici SSD dati locali formano un pool Ceph con tre copie e l’host come dominio di guasto. La capacità grezza è 3 × 4 × 3,84 = 46,08 TB . Tre copie riducono la capacità teorica utilizzabile, prima di metadati e riserve, a 15,36 TB. Con un limite stabilito solo per la pianificazione del 70%, il valore operativo di calcolo è circa 10,75 TB. Non è una capacità Ceph garantita: riempimento OSD, distribuzione, recovery, snapshot e profili reali dei dati vanno misurati.
Se uno dei tre host si guasta, le due copie restanti possono continuare a servire I/O con un parametro min_size configurato correttamente; il pool è quindi degradato. Una terza copia su un terzo dominio di guasto host si può ripristinare solo quando il nodo ritorna o viene sostituito. È un limite di un progetto con esattamente tre nodi. Inoltre la replica Ceph non sostituisce un backup distinto. Proxmox Backup Server va collocato fuori da questi tre host, in un proprio dominio di guasto, con ripristino verificato e un’ulteriore copia esterna. L’articolo DAXS Proxmox Backup Server: verifica, conservazione e ripristino approfondisce il test di ripristino.
Rete e alimentazione fanno parte dell’architettura
Per Ceph contano banda e bassa latenza; per un nuovo cluster pianifichiamo percorsi separati a 25 Gbit con connessioni ridondanti come ipotesi iniziale verificabile. La velocità realmente necessaria deriva da carico di scrittura, traffico di replica e tempo obiettivo di recovery, non dal numero di porte della scheda tecnica. Corosync deve seguire percorsi fisici indipendenti; gestione e traffico VM vengono separati o limitati adeguatamente. Le assegnazioni precise di VLAN, switch e NIC vanno documentate in un piano porte.
Due alimentatori nel server aiutano solo se collegati a percorsi distinti. DAXS farebbe collegare per ogni host l’alimentatore A alla PDU/UPS A e il B alla PDU/UPS B, controllare l’assorbimento sotto carico e provare il guasto di un percorso. Gestione iLO, SSD di ricambio, firmware e finestre di manutenzione sono ulteriori voci operative. Tre server nello stesso rack non proteggono dal guasto dell’intero locale.
Calcolo aperto su tre e cinque anni
Un’offerta HPE attualmente confermata per il nodo completamente equipaggiato sia pari a h euro, la rete ridondante comprese le ottiche a n, un server di backup autonomo con supporti a k. Assistenza HPE e ricambi costano nel modello s euro annui, energia e housing e euro annui. Questi valori di offerta non vengono inventati. I listini Proxmox pubblicati indicano 550 € annui per socket VE occupato e 2.240 € per un server PBS Standard: qui 3 × 550 + 2.240 = 3.890 € all’anno. Si ipotizzano una tantum 80 ore a 90 € (7.200 €) per installazione, prove e consegna; ogni anno 50 ore a 90 € (4.500 €) per l’esercizio.
| Voce | 3 anni | 5 anni |
|---|---|---|
| Nodi, rete, hardware di backup | 3h + n + k | 3h + n + k |
| Installazione una tantum | 7.200 € | 7.200 € |
| VE/PBS + esercizio annuo | 3 × (3.890 + 4.500 + s + e) | 5 × (3.890 + 4.500 + s + e) |
| Totale | 3h + n + k + 32.370 + 3s + 3e € | 3h + n + k + 49.150 + 5s + 5e € |
La sensibilità è leggibile direttamente: 1.000 € in più per nodo aumentano entrambi gli orizzonti di 3.000 €; 1.000 € in più di assistenza HPE annua incidono per 3.000 o 5.000 €. Se ogni host richiede una seconda CPU occupata, al medesimo livello Proxmox Standard si aggiungono soltanto per gli abbonamenti 1.650 € annui, oltre a hardware, RAM ed energia. Il calcolo esclude migrazione da VMware, seconda sede di backup e aumenti dei prezzi; queste voci vanno aggiunte nella decisione concreta.
DAXS verifica prima picchi e obiettivi in caso di guasto, poi distinta HPE approvata, piano porte e alimentazione, ripristino Ceph e backup e offerte complete. Per pianificare un cluster nel proprio ambiente si può usare Contatto per avviare il confronto.
Fonti: HPE ProLiant DL360 Gen11 QuickSpecs · Proxmox VE Administration Guide: cluster, HA e Ceph · Ceph: numero di copie e min_size · Proxmox VE: prezzi degli abbonamenti · Proxmox Backup Server: prezzi.