
Se una sede perde la connessione, decine di messaggi conseguenti non dovrebbero presentare lo stesso guasto come tanti incidenti distinti. Zabbix può riunire metriche, condizioni e notifiche. L’utilità pratica nasce dalla domanda su quale decisione debba attivare un messaggio.
Dal processo aziendale alla misura
Il punto di partenza è un servizio concreto: un’applicazione aziendale accessibile, un backup terminato in tempo o spazio utilizzabile sufficiente. Si scelgono quindi punti di misura tecnici adeguati. Un server che risponde non dimostra ancora che gli utenti possano accedere all’applicazione e ottenere risultati corretti.
Ogni controllo rilevante riceve un responsabile e una risposta attesa. Per la capacità può bastare pianificare per tempo; per un servizio di produzione guasto può servire un contatto diretto. L’importanza deriva dall’effetto sull’operatività, non da un colore particolarmente vistoso.
Le dipendenze riducono le notifiche inutili
Zabbix descrive le dipendenze tra trigger come un mezzo per gestire correttamente gli eventi dipendenti in presenza di un guasto a monte. Questo può aiutare a distinguere il guasto di un collegamento centrale dalle sue conseguenze. La dipendenza deve però corrispondere alla rete reale e alla logica di misura.
Il guasto di una sede non deve nascondere un altro incidente indipendente. Le relazioni vengono quindi verificate su scenari di guasto reali. Anche un ritardo eccessivo o una soglia troppo permissiva possono celare un problema reale. Un elenco di notifiche tranquillo non dimostra da solo la qualità del monitoraggio.
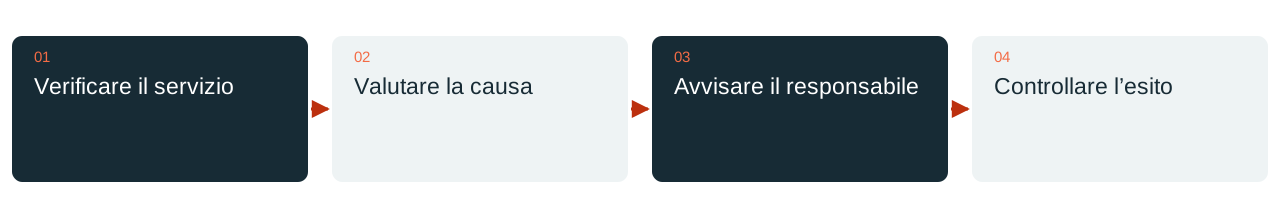
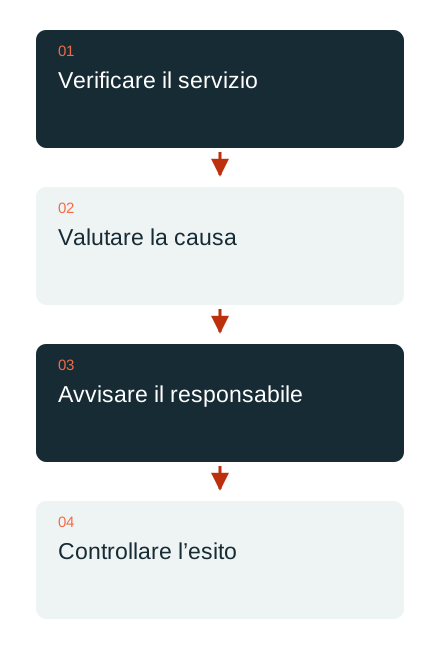
Pianificare finestre di manutenzione ed escalation
La manutenzione pianificata viene rappresentata nel monitoraggio. Zabbix distingue, tra gli altri aspetti, il trattamento della raccolta dati e degli eventi durante la manutenzione. L’impostazione scelta viene verificata consapevolmente, anziché disattivare indiscriminatamente ogni osservazione. Dopo la manutenzione lo stato normale deve tornare riconoscibile.
Il percorso di notifica considera orari di lavoro, canali di risposta concordati e sostituzioni. Questo non implica un impegno generale di disponibilità continua. Un’escalation è utile solo se la persona interessata è raggiungibile e sa quali informazioni riceverà per valutare la situazione.
Testare gli allarmi come una funzione
Un test controllato verifica misura, attivazione, consegna, presa in carico e risoluzione. Ne fa parte anche la notifica di rientro. Per il test è preferibile uno scenario limitato e concordato in anticipo a un intervento imprevisto su un servizio di produzione.
DAXS sviluppa con Zabbix un monitoraggio adatto all’ambiente e lo collega a documentazione e gestione operativa. Un primo passo utile è un numero ridotto di servizi importanti con percorsi di risposta interamente collaudati. Ulteriori punti di misura seguono quando è chiaro quale valore aggiuntivo apportano.
Assistenza e gestione IT · Infrastruttura · Parlare di monitoraggio
Fonti: Zabbix: dipendenze tra trigger (link esterno) · Zabbix: finestre di manutenzione (link esterno)


