Ceph, replica ZFS e SAN o NAS esterni possono aiutare le VM Proxmox a superare il guasto di un host. Differiscono però per aggiornamento dei dati, ripartenza e dominio di guasto. Limitarsi a selezionare «alta disponibilità» spesso nasconde il requisito reale: quanti minuti di perdita dati tollera l’applicazione (RPO) e quando deve essere nuovamente utilizzabile (RTO)?
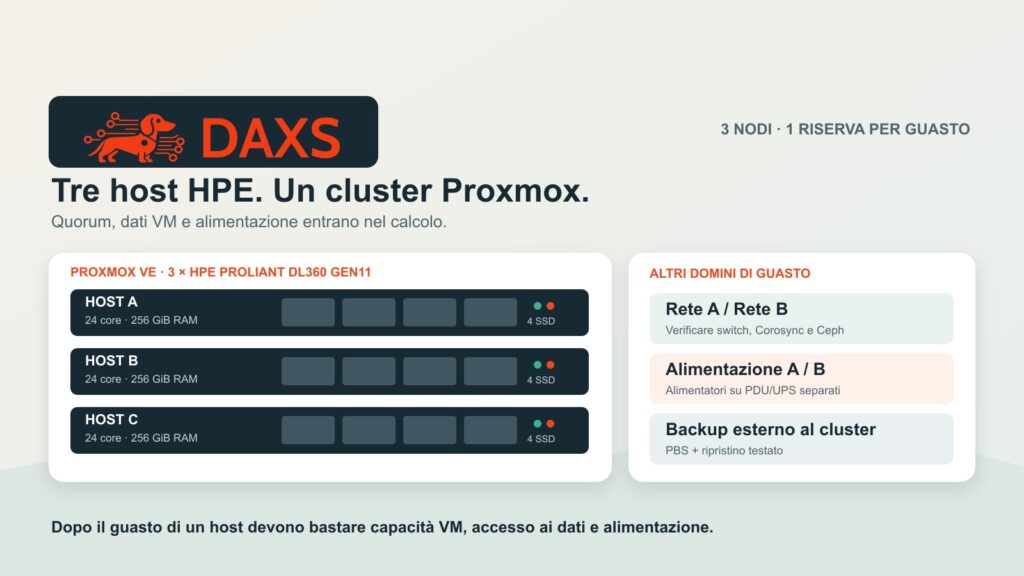
Confrontiamo tre percorsi di storage per lo stesso cluster ipotetico di tre host. Come Ceph ricostruisce le copie dopo un guasto host è descritto separatamente. Qui la decisione parte dalle applicazioni e dai loro obiettivi di ripristino verificabili. Tutti i percorsi richiedono inoltre backup separato e prova di restore.
Tre architetture, tre percorsi di guasto diversi
Ceph su SSD locali fornisce il disco VM come storage a blocchi distribuito e accessibile nel cluster. Un pool replicato conserva copie su più host; quorum, regola del pool, rete e spazio libero devono corrispondere al dominio di guasto host scelto. Dopo il guasto dell’host VM, Proxmox HA può riavviare la VM su un altro host se quorum e risorse sono disponibili. Scrittura in corso, applicazione guest e transazioni vanno comunque valutate nella prova. La sola ridondanza Ceph non promette né VM senza interruzione né RPO zero garantito per ogni applicazione.
ZFS locale con replica dello storage Proxmox trasferisce periodicamente i volumi VM tramite snapshot a un altro host. La destinazione conserva lo stato della più recente replica completata con successo . Proxmox consente HA insieme alla replica, ma avverte esplicitamente della possibile perdita dati dall’ultima sincronizzazione. Un intervallo impostato a cinque minuti non è quindi un impegno RPO generale: ritardi, job falliti e stato applicativo contano. Senza un disco condiviso sincrono, la VM riavviata deve poter gestire proprio quello stato precedente.
Storage condiviso esterno come NFS o iSCSI rende i dischi VM accessibili a più host e normalmente consente live migration senza copiare il disco. Il rischio dati al guasto host dipende dal progetto reale dello storage. Verificare due controller, percorsi dati ed elettrici separati, multipathing iSCSI o rete NFS ridondante, supporto e failover controller testato; un NAS singolo resta un dominio di guasto centrale. La documentazione Proxmox avverte esplicitamente di non rendere un apparato ZFS-over-iSCSI un single point of failure. «Shared» nella configurazione non dimostra una appliance ridondante.
Quale carico tollera quale RPO e RTO?
RPO misura la massima perdita dati accettata, RTO il tempo massimo prima che l’applicazione sia utilizzabile. Le indicazioni seguenti sono domande decisionali, non SLA di prodotto. Per ogni servizio vanno testati insieme database, riavvio VM, DNS, login utenti e sistemi dipendenti.
| Applicazione e obiettivo | Percorso plausibile | Verifica decisiva |
|---|---|---|
| Database ERP transazionale; perdita dati quasi intollerabile | Ceph o storage condiviso con ridondanza dimostrata; eventualmente anche replica applicativa | Latenza di scrittura, coerenza delle transazioni, quorum e riavvio reale con guasto host/storage |
| VM di test interna o servizio web ripristinabile; perdita di minuti accettata | ZFS locale con replica può bastare | Età dell’ultimo snapshot riuscito, allarme sui ritardi, avvio con dati precedenti |
| SAN/NAS esistente e supportato con riserva sufficiente | Continuare a usarlo come storage condiviso può essere economico | Testare insieme controller, percorsi, energia, firmware, manutenzione e failover reale |
Per un database produttivo con RPO molto stretto, la replica ZFS asincrona può essere inadatta anche se il riavvio HA funziona. Al contrario, un servizio di test ripristinabile non giustifica automaticamente Ceph. Tre host Proxmox non rendono ridondante un singolo server di storage. La scelta segue perdita dati accettata e interruzione misurata, oltre al nome del prodotto.
Calcolo a tre e cinque anni senza finti prezzi di mercato
Il confronto ipotetico assume tre host identici con un socket e prezzo d’acquisto h per host e un server di backup separato con supporti al prezzo b . Dal listino attuale del produttore, Proxmox VE Standard costa 550 € per socket CPU occupato e anno, Proxmox Backup Server Standard 2.240 € per server e anno. Il supporto comune è quindi 3 × 550 + 2.240 = 3.890 € annui. Il modello assume 90 € netti per ora lavorata. Non presume uguali IOPS o capacità utile senza verifica: nelle offerte reali tali valori vanno prima normalizzati sullo stesso carico.
d indica SSD dati Ceph aggiuntivi per host, z la dotazione SSD ZFS locale per host, a una appliance esterna progettata ridondante, nc, nz e ns gli investimenti di rete o fabric necessari per ogni caso. ec, ez e es sono costi annui aggiuntivi di energia/housing; s è il contratto annuo di assistenza del produttore dell’appliance esterna. Tutte le lettere sono importi d’offerta netti in euro, non presunti prezzi di mercato.
| Percorso | Allestimento / gestione annua | 3 anni | 5 anni |
|---|---|---|---|
| Ceph | 80 h / 50 h | 3h + b + 3d + nc + 32.370 + 3ec € | 3h + b + 3d + nc + 49.150 + 5ec € |
| Replica ZFS | 50 h / 30 h | 3h + b + 3z + nz + 24.270 + 3ez € | 3h + b + 3z + nz + 37.450 + 5ez € |
| Storage esterno | 60 h / 35 h | 3h + b + a + ns + 26.520 + 3s + 3es € | 3h + b + a + ns + 40.600 + 5s + 5es € |
Le ore sono pure ipotesi del modello, non un forfait DAXS. Esempio: 1.000 € in più di assistenza annua sull’appliance aumentano la variante esterna di 3.000 € a tre anni e 5.000 € a cinque anni. Un’appliance esistente può ridurre a nel periodo, ma vita residua, supporto, ricambi ed espansione rientrano in s o in una voce d’investimento separata. Prezzi hardware, consumo di spazio, prestazioni, rete, imposte e luogo operativo vanno documentati con offerte. Il valore più basso della formula non basta all’acquisto senza pari capacità utile, IOPS, RPO e RTO.
Collaudo: simulare davvero un guasto per dominio
DAXS richiederebbe quattro prove per ogni architettura candidata: (1) registrare l’istante dell’ultimo stato applicativo coerente, (2) misurare guasto host e riavvio VM sotto carico, (3) interrompere anche il percorso critico di storage o rete e (4) ripristinare VM e singoli dati applicativi da un backup separato . Per ZFS includere job di replica falliti o in ritardo; per Ceph pool degradato e ricostruzione; per SAN/NAS cambio di controller e percorsi. Le misure decidono se RPO e RTO sono rispettati.
Copie Ceph, snapshot di replica e mirroring dell’array propagano anche cancellazioni e dati errati. Non sostituiscono versionamento, copia esterna o prova di restore. Il contributo DAXS Proxmox Backup Server: verifica, conservazione e ripristino approfondisce il collaudo dei backup. Con un elenco applicativo e obiettivi RPO/RTO, tramite Contatti si possono misurare con DAXS i tre percorsi sul carico reale e sui contratti esistenti.
Fonti: Proxmox VE Administration Guide: storage, replica dello storage e HA · Proxmox VE: prezzi attuali del supporto · Proxmox Backup Server: prezzi attuali del supporto.